

 テキストアノテーション
 音声アノテーション
 画像・動画アノテーション
 生成AI、LLM、RAGデータ構造化
 AIモデル開発
 内製化支援
 医療業界向け
 自動車業界向け
 IT業界向け
 製造業向け

AI学習用の日本語音声データ収録の外注をご検討中の方へ
こんなお悩みはありませんか?
- ・AI学習用の音声データを集めたいが、どのように要件を決めればよいかわからない
- ・話者のリクルートや属性管理まで外注できるのか知りたい
- ・収録後に品質不適合が多発しないか不安
- ・短納期で大量の日本語音声データを集めたい
本記事では、当社が対応した249時間規模の会話収録案件で得た知見を基に、これらの課題を解決するための実務ポイントを解説します。
- 目次
1. 音声データ収録プロジェクトの概要
AIによる音声認識や音声対話への期待が高まる中、音声の学習データはそのニーズに応えるための重要な要素となっています。
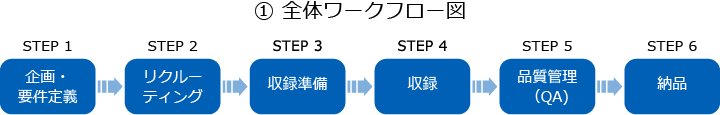
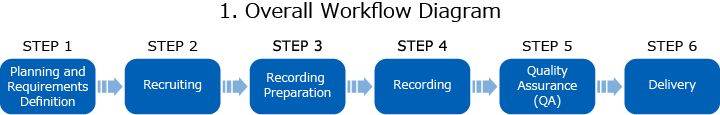
会話形式の音声データ収集では、実際の利用環境に近い状況で人と人との自然な会話を再現しつつ、AI学習に適した形式・品質で収録を行う必要があります。発話内容だけでなく、話者の属性や収録条件など、多様な要件を満たした高品質な音声データが求められます。AI学習用の音声データ収録では、「聞き取れればよい」「環境音は入ってもよい」といった一見シンプルな要件でも、納品段階で品質認識のずれが発生することがあります。下の図は、要件定義から納品までの全体フローです。次章以降で各工程のポイントを解説します。
▼関連ブログ
AI音声認識とは〜音声認識の仕組みと活用事例4選〜
1-1. 後戻りを防ぐための要件定義のポイント
AI学習用の音声データ収録のご相談は増えていますが、要件が十分に固まらないまま進行を求められ、納品後に新たな条件が追加されるケースも少なくありません。
実際に当社が対応した249時間分の音声収録案件でも、収録条件、話者属性、ノイズ基準、差し戻し対応を事前にどこまで具体化できるかが、プロジェクト全体の成否を左右しました。
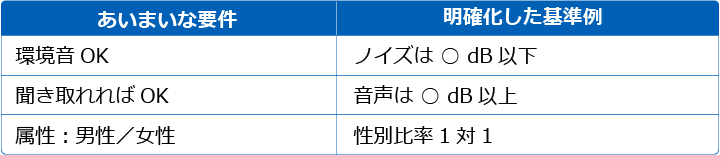
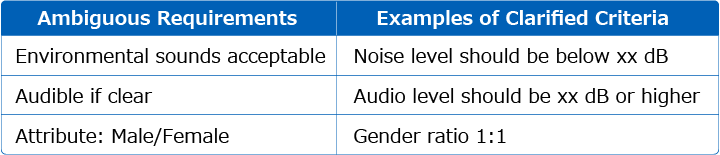
実案件では、次のような認識ずれが発生しました。お客様の方で想定しきれていないと思われる部分は、数値で基準化・言語化し、あいまいさを極力取り除いた状態で合意を得ることが必要です。
外注時によくある認識ずれの例:
- ・「環境音は入っていてOK」だったが、納品後にノイズが大きすぎると指摘された
- ・「聞き取れればOK」だったが、声量が小さすぎると指摘された
- ・「男性/女性の属性指定」だけだったが、性別比率1対1が求められた
1-2. 属性分布を確保するリクルーティング設計
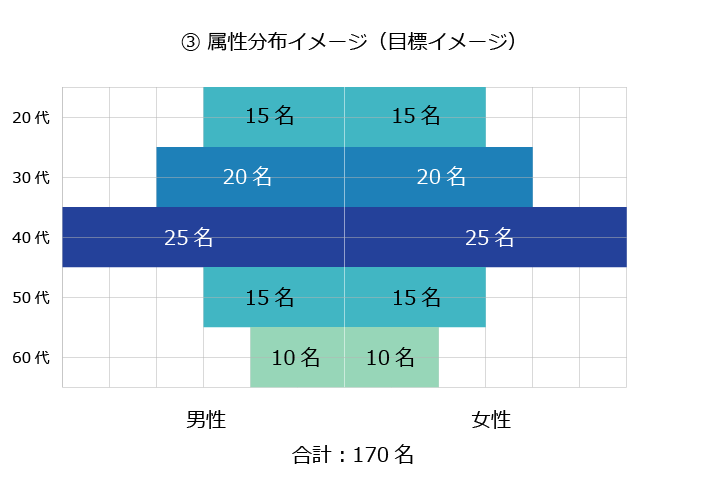
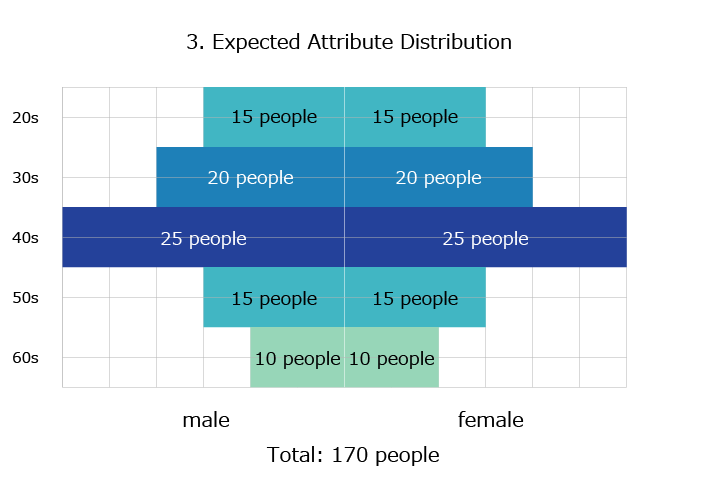
属性の要件として、性別、年齢、地域、学歴などの分布が求められます。実際に話者のリクルートを進めると、確保が難しい属性がボトルネックになることがあります。例えばオンライン収録では、PC操作に慣れた参加者が集まりやすい一方、70代・80代の参加者の確保が難しくなる場合があります。
加えて、日本の人口分布の関係で居住地域による制約も大きく、方言の収録は難航しがちです。分布設計については初期の段階でボトルネックを見極め、分布比率や許容範囲についてお客様と事前にすり合わせておくと安心です。また、1人あたりの収録可能時間(制限)は作業負荷に大きく影響します。1人あたりの収録可能時間が2時間の場合と1時間の場合とでは必要人数が倍になるため、この点にも注意が必要です。
1-3. 会話収録で重要な話者別トラック管理
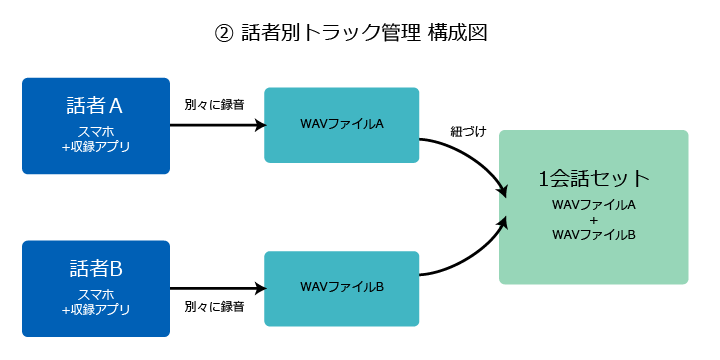
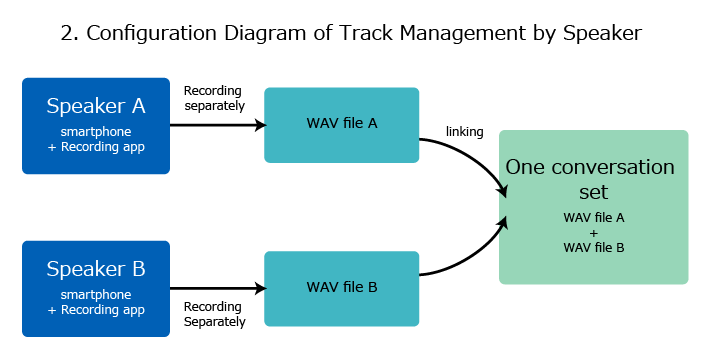
AI学習用の会話収録では、話者ごとの音声を個別に抽出できる状態で納品する必要があります。そのため、1つの会話であっても話者ごとにマイクを分け、音声を別々に録音します。話者ごとに個別のWAVファイルを作成することで、学習データとして必要な音声の切り分けが可能になります。
・収録方法の選択肢
実際の収録では、参加者の環境や技術的なハードルを考慮し、以下のような方法を使い分けます。
| 収録方法 | 概要 | メリット | 注意点 |
|---|---|---|---|
| スマートフォン+録 音アプリ |
各話者のスマートフォンに指定の録音アプリをインストールし、端末のマイクで収録 | 特別な機材が不要で参加者の負担が少ない。リクルート対象を広げやすい | 端末ごとのマイク性能差により音質にばらつきが出やすい |
| PC+録音アプリ+ ヘッドセット |
PCに録音アプリをインストールし、ヘッドセットを使用して収録 | 安定した音量を確保しやすい。音声の混入が起きにくい | PC操作に不慣れな参加者にはハードルが高い |
・ファイル管理のポイント
会話ID・カテゴリID・話者IDなどを含む命名規則をあらかじめ定めておくと、大量のファイルを管理する際の混乱を防げます。(例:Tokyo001_spk01.wav)
1-4. 運用指示と収録現場での工夫
実際の音声収録現場では、言葉に詰まったり、ノイズが大きすぎて学習データの要件を満たせなかったりと、スムーズにいかないこともあります。事前にシナリオやトピックを準備し、注意事項をレクチャーするなど、収録に際しては実践的な工夫も必要になります。
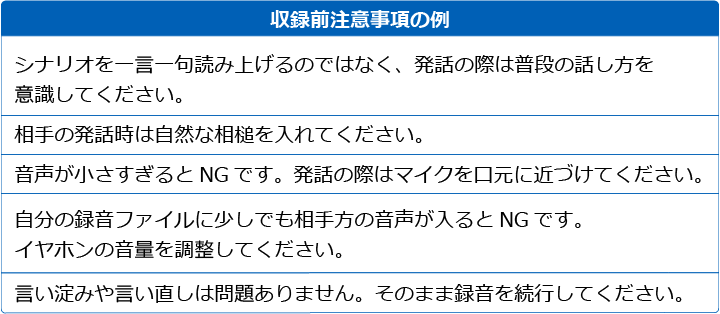
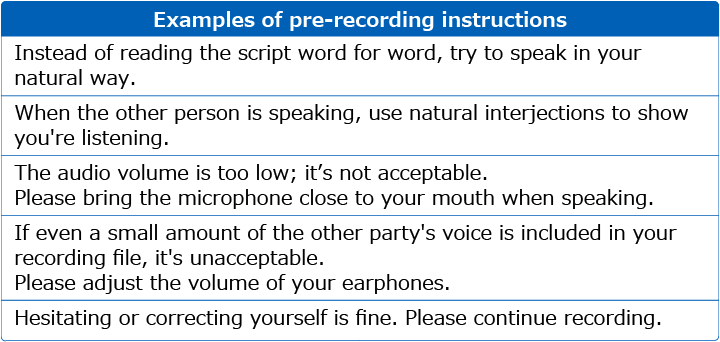
以下は実際の案件で使った収録前の注意事項の一例です。収録時は、数値的な基準を書くよりも作業上の注意点を具体的に伝えたほうが音声の差し戻し率の低減につながります。
1-5. パイロットプロジェクトと事前品質チェック
音声データ収録では要件のすり合わせが難しいことも多いため、本収録の前にパイロットプロジェクトの実施をお客様にお願いしています。パイロットでは少人数(例:2〜3ペア程度)で実際の収録フローを一通り実施し、以下の点を検証します。
- ✓設定したノイズ基準・音量基準が現実的か
- ✓収録手順やアプリの操作に問題がないか
- ✓想定どおりの自然な会話が収録できているか
- ✓差し戻し率はどの程度発生するか
また、パイロットとは別に、収録に参加する方全員に事前に音声サンプルを提出してもらい、数値基準に基づいて合否を判定します。パイロットの結果を踏まえて基準や手順を調整し、お客様と合意したうえで本番の収録に進みます。
ただし、差し戻しを完全に防ぐことは困難なため、一定の差し戻しが発生することを前提にバッファを設定して必要な収録時間を決定します。
1-6. 短納期案件を成立させる進行管理
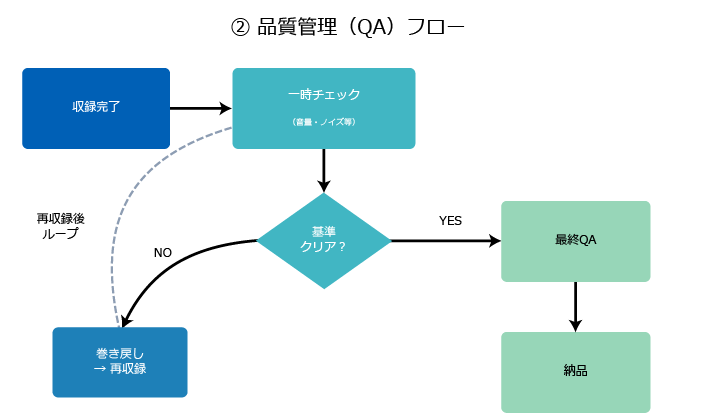
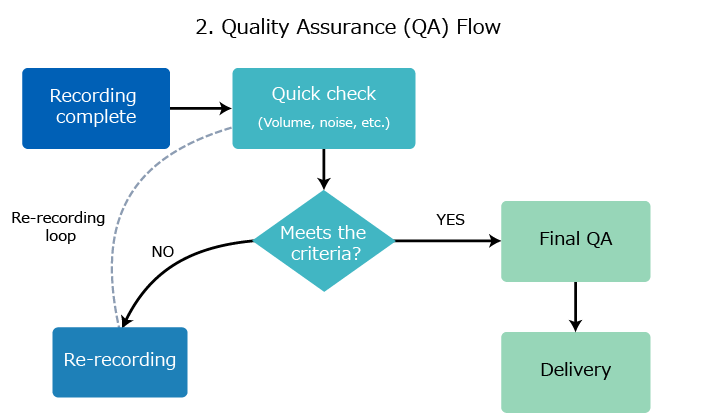
短納期案件では、収録・確認・差し戻し対応を並行して進められる進行管理体制が重要です。すべての収録が完了してから品質チェックを行う直列型のフローでは、問題の発覚が遅れ、スケジュールが破綻するリスクがあります。
本案件では、以下のような運用で工程を並行して進めました。
- ✓収録完了分から順次品質チェックを行い、基準を満たさない音声は早期に差し戻し
- ✓属性ごとの収録状況を週次で集計し、不足している属性のリクルートを優先的に進行
- ✓差し戻し分の再収録枠をあらかじめスケジュールに組み込んでおく
進捗を可視化し、ボトルネックになりやすい属性や収録条件を早期に把握することで、249時間規模の案件でも納期遅延のリスクを抑えられます。
2. まとめ
AI学習用の音声データ収録では、「収録すること」自体よりも、その前後の設計と管理がプロジェクトの成否を左右します。本記事のポイントを振り返ります。
- ✓要件定義:あいまいな要件を数値で基準化し、認識のずれを事前に防ぐ
- ✓リクルーティング設計:確保が難しい属性を早期に見極め、分布比率をすり合わせておく
- ✓話者別トラック管理:収録方法の選定とファイル命名規則の統一で、大量データの管理ミスを防ぐ
- ✓運用指示:数値基準よりも具体的な作業上の注意点を伝え、差し戻し率を低減する
- ✓品質管理:事前のサンプルチェックとバッファ設計で、差し戻しリスクに備える
- ✓パイロット実施:本収録前に少人数で検証し、基準と手順の妥当性を確認する
- ✓進行管理:工程を並行化し、ボトルネックを早期に把握して納期遅延を防ぐ
これらのポイントを押さえることで品質と納期の両立が可能になります。
当社では、収録要件の整理、話者リクルーティング、収録運用、品質チェック、差し戻し対応までを一貫して支援しています。要件が固まりきっていない段階でも、まずは必要な条件の洗い出しからお気軽にご相談ください。




 ページの先頭に戻る
 03-5321-3111[東京本社]
 お問い合わせ
 資料請求
 TOP
 SITEMENU